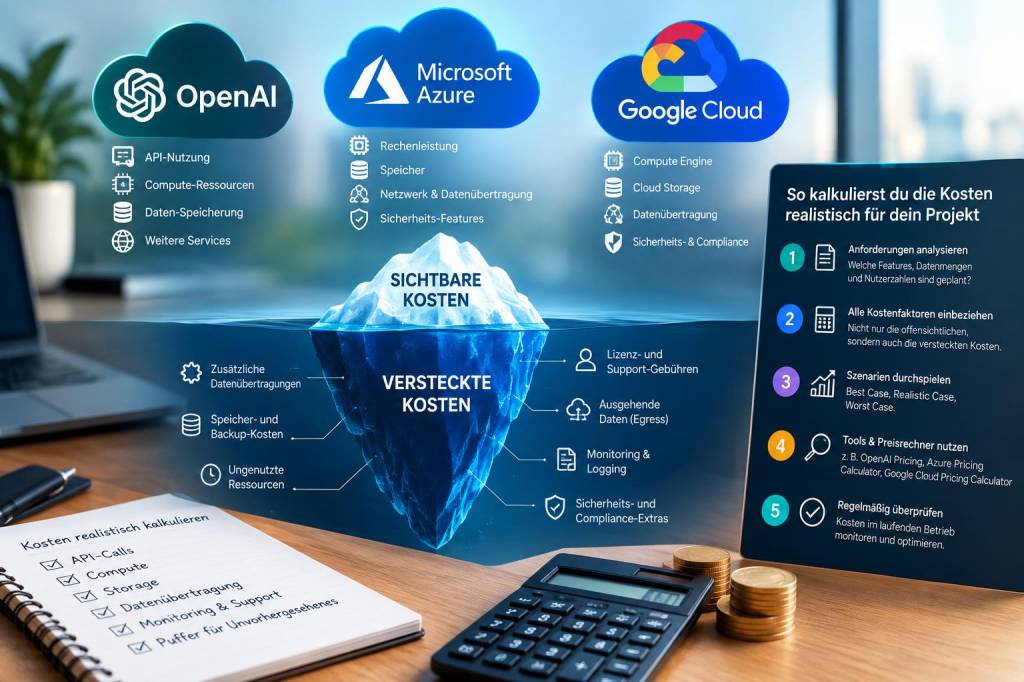
Wenn ich Projekte mit KI-APIs plane, stoße ich immer wieder auf dasselbe Problem: Die offensichtlichsten Kostenpunkte sind schnell gelistet — Tokens, Calls, VM‑Stunden — aber die versteckten Kosten kommen später und schlagen oft deutlich zu Buche. In diesem Artikel erkläre ich aus der Praxis, welche versteckten Kosten bei OpenAI, Azure und Google Cloud entstehen können und wie du sie realistisch in dein Projektbudget einrechnest.
Was meine ich mit „versteckten Kosten“?
Mit versteckten Kosten meine ich Ausgaben, die nicht auf den ersten Blick in den Preislisten der Anbieter stehen oder die Entwickler bei der Prototypenphase leicht unterschätzen. Dazu gehören Infrastruktur‑Overhead, Datenvorbereitung, Monitoring, Sicherheit, Test‑ und Staging‑Umgebungen, Netzwerktraffic, wiederholte API‑Calls durch Retries, Kosten durch schlechte Modellwahl (zu teure Inferenz) und Steuern/Compliance‑Aufwand.
Kategorien versteckter Kosten
- Datenkosten: Speicherung, Transfer, Labeling, Cleaning.
- Compute‑Overhead: Warmup‑VMs, Autoscaling‑Spitzen, GPU‑Kosten für Training/Finetuning.
- API‑Effizienz: Token‑Waste, wiederholte Anfragen, Mehrfachabfragen für Robustheit.
- Netzwerk & Bandbreite: Ausgehender Traffic, Cross‑Region egress.
- Sicherheit & Compliance: Verschlüsselung, Logging, Pen‑Tests, DSGVO‑Aufwand.
- Monitoring & Observability: Logs, Traces, APM‑Tools (Datadog, New Relic).
- Entwicklungs- & Betriebskosten: Staging‑Umgebungen, CI/CD, Rollbacks, On‑Call.
- Vertrags- & Lizenzkosten: SLA‑Upgrades, Support‑Pakete, Marketplace‑Addons.
Konkrete Fallstricke bei OpenAI, Azure und Google Cloud
Hier schildere ich typische Fallen für jeden Anbieter, basierend auf eigenen Tests und realen Projekten.
OpenAI
OpenAI verrechnet primär nach Tokens und Modellen. Doch darauf solltest du achten:
- Unvorhergesehene Token‑Schwankungen: Bei dynamischen Prompts können Token‑Mengen stark variieren — besonders bei Nutzereingaben mit vielen Kontextdokumenten.
- Context Window & Chunking: Längere Kontexte erfordern Chunking, was zu mehrfacher Verarbeitung derselben Dokumente führt.
- Retrieval + Generation Stack: Kombination aus Pinecone/Weaviate + OpenAI erhöht Calls (Embeddings + Retrieval + Generation).
- Fine‑Tuning & Embeddings: Fine‑Tuning kann teuer und zeitaufwendig sein; Embedding‑Preprocessing (Batching) kann Compute‑Spitzen verursachen.
- Rate Limits & Retries: Automatische Retries können ohne Backoff exponentiell Kosten erhöhen.
Microsoft Azure (OpenAI Service & Azure Infrastruktur)
Azure kombiniert OpenAI‑Modelle mit klassischer Cloudinfrastruktur — das macht Kosten komplex:
- Regionale Premiumpreise: Managed OpenAI Services kosten in bestimmten Regionen mehr; Cross‑Region Datenzugriffe verursachen Egress.
- VMs & Scale‑Sets: Für Inferenz oder Preprocessing brauchst du VMs/GPU‑Instanzen, die teuer sind, wenn sie lange vorgehalten werden.
- Azure Cognitive Services & Storage: Blob‑Storage, Cognitive Search, Key Vault für Secretsmanagement — alles zusätzliche Posten.
- Support‑Level: Business Critical SLAs oder Proactive Support kosten extra.
Google Cloud Platform (Vertex AI, Compute Engine)
Google bietet mächtige Tools, aber es gibt auch Überraschungen:
- Vertex AI Training vs. Inference: Training großer Modelle ist teuer; Inferenz in mehreren Zonen kann Lead‑Time und Egress erhöhen.
- Preemptible/Spot‑Instanzen: Kostensparend, aber können Jobs abbrechen und Re‑Runs verursachen.
- Networking Costs: Egress zwischen Regionen oder aus GCP heraus kann das Budget sprengen.
- Managed Services Extras: API Gateway, Cloud Functions, Pub/Sub für Orchestrierung – kleine Posten summieren sich.
Wie ich Kosten realistisch kalkuliere — Schritt für Schritt
Ich habe eine pragmatische Methode entwickelt, die du übernehmen kannst:
- 1. Zerlege dein System in Bausteine: Datenaufnahme, Preprocessing, Modellinferenz, Postprocessing, Speicherung, Monitoring.
- 2. Schätze Calls & Durchsatz: Wie viele Requests pro Sekunde, durchschnittliche Antwortgröße (Tokens), Peak‑Traffic.
- 3. Simuliere Verbrauch: Nutze Lasttests oder analytische Schätzungen (z. B. durchschnittlich 500 Tokens/request × X Requests/Tag).
- 4. Addiere Overhead: +20–40% für Retries, Chunking, Logging; +30–100% für Spitzen/Autoscaling (abhängig von SLAs).
- 5. Berücksichtige Speicherung & Transfer: Kosten pro GB/Monat plus Egress‑Rate multipliziert mit Datenvolumen.
- 6. Budget für Entwicklung & Support: 10–25% des Jahresbetrags für Entwicklung, Tests, Security Audits einplanen.
Praktische Rechenbeispiele
Ein einfaches Beispiel: Ein Chatbot mit 10.000 Nutzern/Tag, im Schnitt 3 Requests/Nutzer, durchschnittlich 400 Tokens/Antwort. Wir betrachten OpenAI‑Kosten (Modell: gpt‑4o‑mini, 0,002 USD/1K tokens hypothetisch) + 30% Overhead.
| Parameter | Wert |
|---|---|
| Requests/Tag | 30.000 |
| Tokens/Response | 400 |
| Tokens/Tag | 12.000.000 |
| Grundkosten (0,002$/1K Tokens) | 24 USD/Tag |
| Overhead (30%) | 7,2 USD/Tag |
| Gesamt/Tag | 31,2 USD → ~936 USD/Monat |
Das ist eine stark vereinfachte Rechnung — in der Praxis kommen noch Storage, Embeddings, Preprocessing‑VMs, Monitoring‑Tools und Support dazu. Rechne realistischerweise +50–150% auf die API‑Grundkosten, bis du alle Nebenkosten berücksichtigt hast.
Tipps, um versteckte Kosten zu reduzieren
- Batching & Prompt‑Optimierung: Reduziere Tokens durch kürzere Prompts, systematische Prompt‑Templates und Batching.
- Cache Ergebnisse: Für häufige, deterministische Antworten Caching nutzen (Redis, CDN).
- Hybrid‑Architektur: Kombiniere lokale Modelle + Cloud‑APIs: lokale Modelle für günstige, einfache Aufgaben, Cloud für komplexe Fälle.
- Autoscaling richtig konfigurieren: Warm Pools, minimale Instanzen vermeiden unnötige Kosten.
- Monitoring & Alerts: Kosten‑Alerts einrichten (Billing Budgets, Cost Anomalies), um Überraschungen zu erkennen.
- Entwicklungsumgebung sparen: Preemptible/Spot für Batch‑Jobs, kostenbewusste Storage‑Tiers nutzen.
Wie ich Projekte budgetiere — eine Checkliste
- Grundkosten API (Prediction, Tokens oder Stunden)
- Data Pipeline: Storage + Transfer
- Compute für Preprocessing, Training, Inferenz
- Monitoring, Logging, Observability
- Sicherheit & Compliance (Verschlüsselung, Audits)
- Support & SLAs
- Entwicklung, Tests, Staging
- Reserve für Unvorhergesehenes (20–50%)
Wenn du möchtest, kann ich dir ein kleines Kalkulationssheet vorbereiten (CSV oder Google Sheet), das du für erste Schätzungen füllen kannst. In meinen Projekten hat sich gezeigt: Wer die versteckten Kosten von Anfang an einplant, bleibt budgettreu und kann sinnvolle Kompromisse zwischen Kosten und Qualität treffen — statt teure Überraschungen zu erleben.